MiniMax H3 разделяет создание видео на два вычислительных этапа. Сначала базовая модель строит сцену и движение в 768p, затем Regenerate 2K заново рассчитывает её в высоком разрешении. Дополнительная работа приходится на поверхности, мелкие предметы и фактуру, которые в черновике занимали слишком мало пикселей.
Для второго этапа существуют две разные реализации. MiniMax предоставляет закрытый сервис H3-Regenerate-2K. NVIDIA выпустила Open-H3-Regenerate-2K — модель для самостоятельного запуска с тремя шагами повторной генерации. Открытая реализация принимает также черновики других видеомоделей и поддерживает выход вплоть до 4K.
От описания сцены к видео со звуком
В официальной системе MiniMax H3 перед генерацией работает H3-Context-IR: он разбирает текст, изображения, звук и видео, устанавливает связи между ними и формирует структурированное описание. Система может уточнять недостающие подробности. Этот подготовительный компонент доступен через сервис MiniMax; скачиваемые веса относятся к базовой модели.
У базы два семейства весов. FL2VA создаёт видео по тексту и допускает начальный, конечный или оба кадра. Так можно задать внешний вид сцены в начале и конце движения. Ref2VA работает с изображениями, видеозаписями и аудиореференсами. Оба семейства формируют видео вместе со звуком.
Официальный второй этап получает 768p-результат вместе с исходным контекстом и создаёт 2K-версию. В такой последовательности подробное описание продолжает участвовать в обработке после того, как композиция уже появилась в черновике.
Как второй проход добавляет подробности
В Open-H3-Regenerate-2K исходное видео сначала кодируется в латент — числовое представление кадров, с которым работает модель. Отдельная трёхмерная свёрточная сеть увеличивает его пространственную сетку. Затем система добавляет шум и за три шага рассчитывает изображение на этой более крупной сетке.
Само увеличение сетки переносит расположение объектов, цвета и движение. Новую прорисовку поверхностей выполняют последующие шаги генерации. Финальный декодер VAE превращает числовое представление обратно в кадры. Поэтому детали появляются после повторного расчёта: шерсть получает отдельные волоски, а материал — мелкую фактуру.
В опубликованном сравнении разработчиков один и тот же участок кадра показан до и после обработки. Ниже — исходный фрагмент с шерстью и пятнами, затем соответствующий результат Open-H3. Сравнение относится к материалам команды проекта.
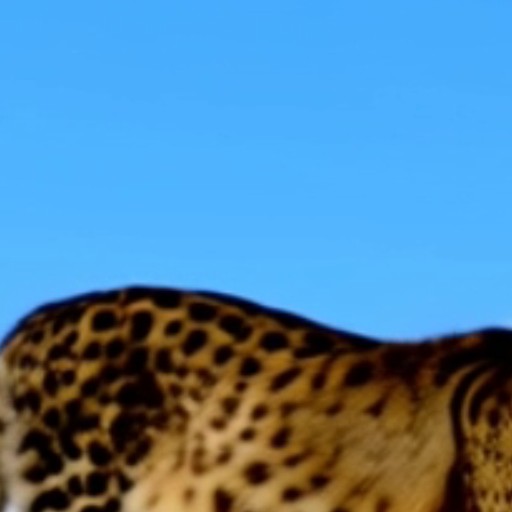
Исходный фрагмент: NVIDIA / Open-H3-Regenerate-2K, Sana-assets, MIT.
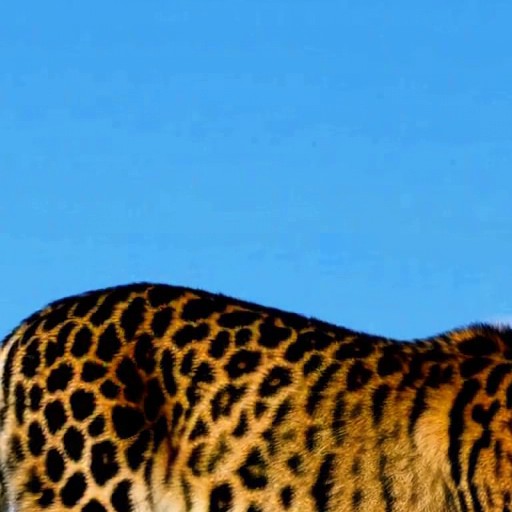
После повторной генерации: NVIDIA / Open-H3-Regenerate-2K, Sana-assets, MIT.
Что меняется в модели, а что остаётся прежним
Разработчики сохраняют основные веса H3 и его VAE, а обучают отдельный адаптер LoRA — сравнительно небольшой набор добавочных параметров. При обучении берут качественный ролик и его ухудшенную копию. Модель учится по этой копии восстанавливать высокое разрешение. Для запуска адаптер объединён с компонентами LightX2V Turbo и LMS Sharp.
В исходной реализации NVIDIA три шага начинаются примерно с уровня шума 0,909. Каждый шаг вызывает тяжёлую модель на полном выходном разрешении. Степень внесённого шума влияет на то, насколько сильно исходные формы будут перерисованы. Это настройка самого процесса восстановления, а не резкость готового файла.
Проект публикует примеры с черновиками H3, LTX-2 и SANA-Video. Среди сцен — город, танец, фехтование и животные. Поддерживаемая длительность одного прохода — от пяти до пятнадцати секунд; доступны 768p, 1080p, 2560×1440 и 3840×2160.
Локальная схема в ComfyUI
Для ComfyUI существует отдельное расширение Open-H3-Regenerate. Оно подключает базовую FL2VA, адаптер повторной генерации, модель увеличения латента и декодер. Для увеличения требуется также узел H3-Latent-Upscaler. Базовая модель, LoRA и декодер загружаются как отдельные компоненты.
Текущие примеры расширения используют начальный шум 0,8, чтобы ближе следовать черновику; исходная схема NVIDIA использует примерно 0,909. Разработчик расширения описывает собственный тест: при более сильном вмешательстве лиса становится похожа на волка — темнеет шерсть, пропадают характерные кончики ушей, хотя расположение и движение сохраняются. Выбор уровня шума определяет и свободу перерисовки деталей.
Аудиодорожка обрабатывается отдельно от видеодеталей: расширение может передать звук черновика или закодированную тишину. Узлы Save Refined Latent и Load Refined Latent сохраняют и загружают уже рассчитанное промежуточное представление вместе с числом кадров и звуком. Если декодирование не помещается в память, подготовленный результат можно декодировать отдельно, без повторения трёх шагов.
Сколько стоит высокое разрешение
В измерениях команды Open-H3 пятисекундный фрагмент из латента 768p в 2560×1440 обрабатывается за 87,26 секунды стандартным вариантом и за 22,45 секунды — с SoL-Engine и быстрым VAE-декодером. Это прогретые запуски на одном графическом ускорителе NVIDIA B200, медианы трёх измерений; учтены увеличение латента, три шага и декодирование. Создание первоначального черновика в эти числа не входит.
Ускоренный путь использует разреженное внимание, MXFP8 и CUDA-графы. По документации кода NVIDIA такой запуск требует около 150 ГБ памяти одного ускорителя. Эта конфигурация описывает серверное оборудование; время и память локального расширения зависят от его собственного пути вычисления и декодирования.
Двухэтапная схема оставляет отдельно исходный черновик и уточнённый латент. На первом этапе появляются композиция и движение, на втором — новая прорисовка поверхностей. Сохранённый после повторной генерации латент можно декодировать отдельно: получение готовых кадров становится самостоятельным этапом работы.